


Em resumo
A tese central da palestra de Caio Sartoratto Prado, especialista de novos negócios da Contabilizei, é que persona sintética gerada só por prompt é "a média da média da internet": estereotipada, de baixa variância e enviesada para um perfil mais escolarizado e rico. Mas quando construída a partir de dados públicos reais (IBGE, Bacen, Caged) e cruzamento determinístico, o erro médio contra pesquisa real cai para 3,3 pontos percentuais, contra 12 pp do Gemini puro e 19,5 pp do GPT puro. Ainda assim, a técnica tem limites claros: funciona bem para priorização de features e teste A/B, mas falha em hábito declarado, elasticidade de preço e qualquer pergunta sobre satisfação (NPS) ou experiência emocional/passada.
- Erro médio do painel contra pesquisa real: 3,3 pp, contra 12 pp (Gemini 3.1 Pro) e 19,5 pp (GPT-5.6)
- Arquitetura: 787 personas, 105 fatos com fonte, zero chamadas de LLM dentro do servidor de dados
- Caso citado do Nubank: ciclo de atualização de agente caiu de 21,2 para 4,4 dias, com +36,7 pontos de tNPS
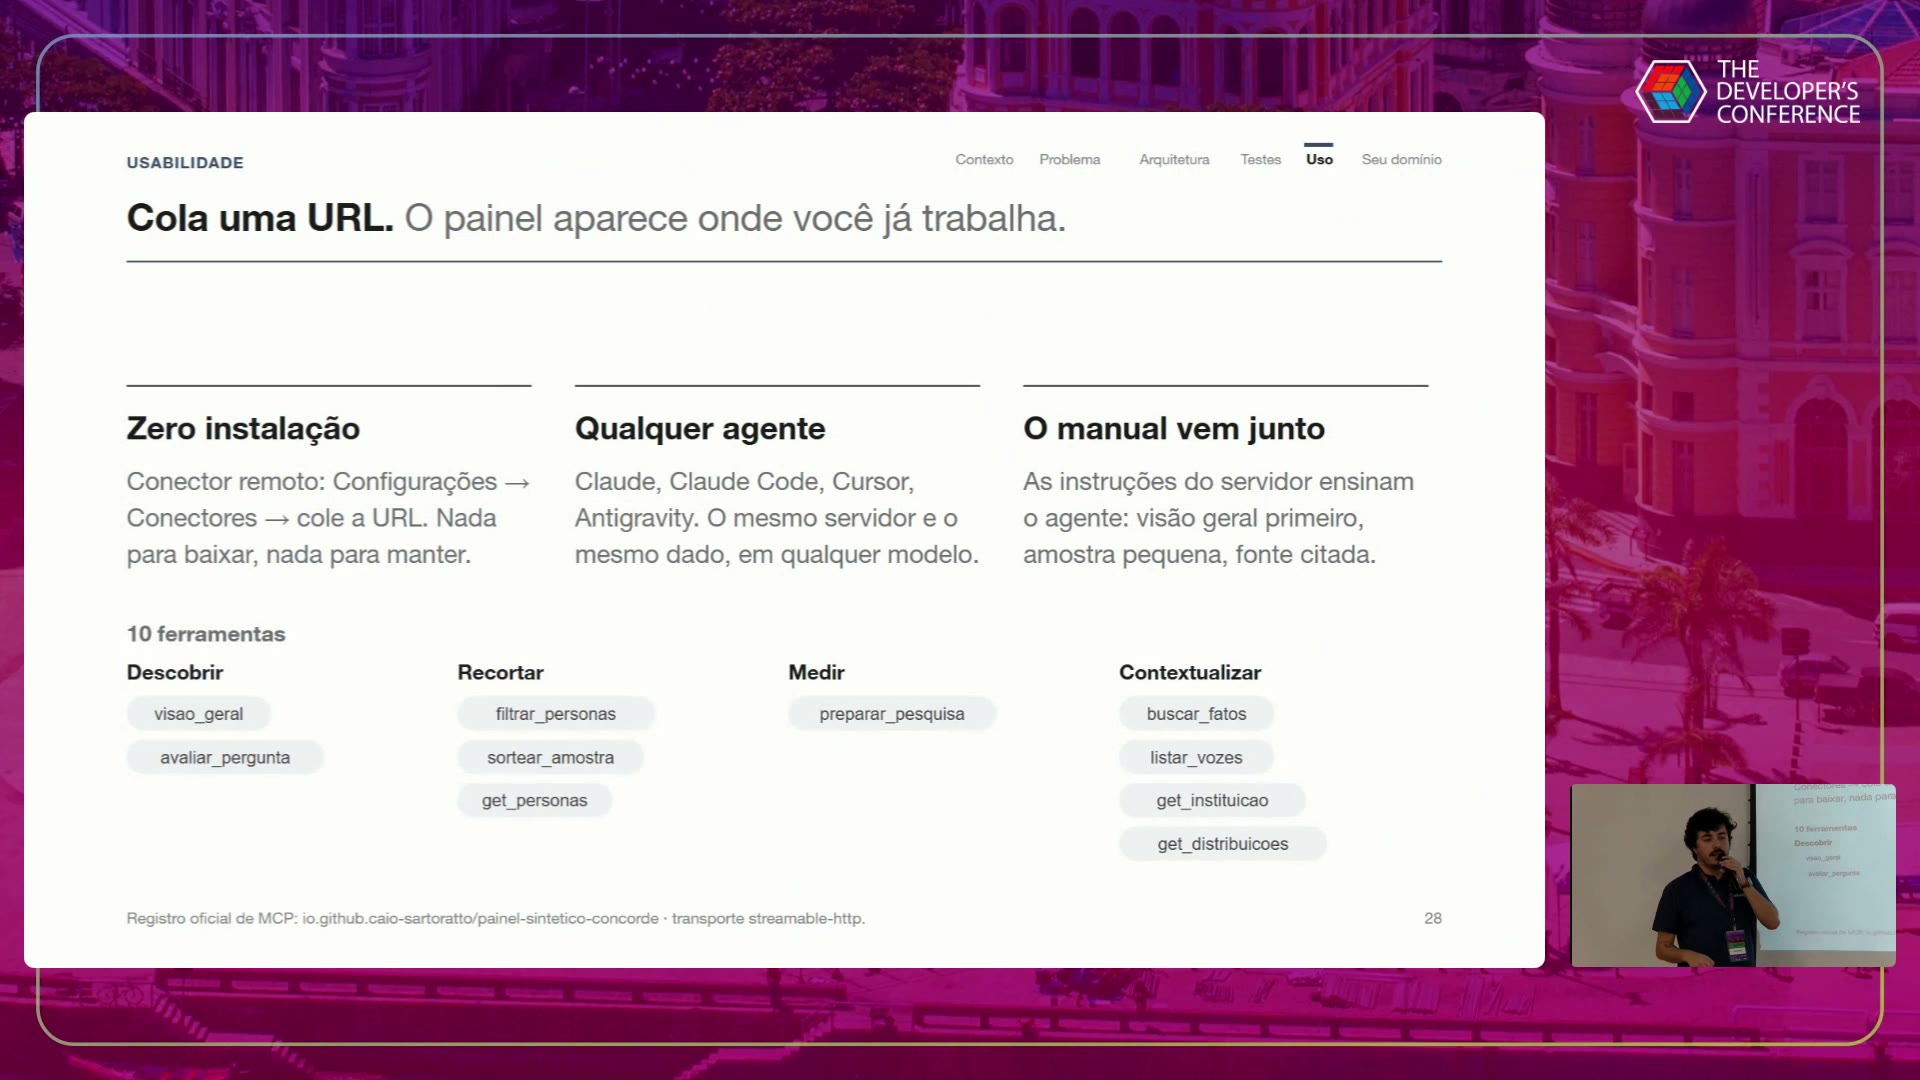
- O painel está publicado no GitHub e opera como servidor MCP, conectável a Claude, Cursor e outros agentes
- 3,3 ppErro médio do painel contra pesquisa real, versus 12 pp do Gemini puro e 19,5 pp do GPT puro
- 787Personas no painel, com 105 fatos com fonte e zero chamadas de LLM no servidor
- 21,2 para 4,4 diasCiclo de atualização de agente de IA do Nubank com clientes sintéticos
- +36,7 ptsGanho de tNPS no teste A/B real do Nubank com o agente orientado por simulação
1. O problema que a persona sintética promete resolver
Caio abriu com o personagem Tiago: um vendedor CLT de 32 anos, do Nordeste, com dívida ativa de quase sete mil reais e renda familiar de quase três mil. "O Tiago não existe", disse ele, "e a gente tem quase oitocentas personas muito parecidas com ele que a gente criou para tentar entender esse primeiro comportamento antes da pesquisa real." A motivação é prática: pesquisa de UX tradicional é lenta e cada vez mais difícil de fazer responder. A ficha de persona estática (foto, backstory, dores) usada em Figma e Miro é o ponto de partida, mas é estática. A evolução proposta é uma persona que interage e permite aprofundar nas dores.
2. O case que convenceu a sala: atendimento de cartão de crédito
Citando um paper sobre uma operação de atendimento via LLM para delivery, fraude e problemas de cartão, Caio detalhou como testes A/B entre prompts e multiagentes demoravam 22 dias em média. Com personas sintéticas simulando o teste antes, o ciclo caiu para quatro dias, uma aceleração de cinco vezes, resultando em 37 pontos percentuais de ganho de NPS na ponta.
"Eles saíram de vinte e um dias de teste para quatro dias, então aumentaram cinco vezes a velocidade do teste com personas sintéticas."
O case é o mesmo que a Nubank publicou oficialmente em 5 de novembro de 2026: segundo a sala de imprensa da companhia, o ciclo de atualização do agente Card Management caiu de 21,2 para 4,4 dias, com +4,9 pp de autoatendimento e +36,7 pontos de tNPS em teste A/B real com 27,8 mil clientes. A nota de imprensa do Nubank é explícita sobre um ponto que a palestra não detalhou: a simulação serve para classificar corretamente as alternativas antes do teste real, não para substituir o teste com humanos, e os próprios simuladores precisam ser validados antes de as equipes confiarem neles.
Tabela 1. Caso Nubank: ciclo de desenvolvimento de agente de IA
| Métrica | Sem simulação | Com clientes sintéticos |
|---|---|---|
| Dias por versão do agente | 21,2 | 4,4 |
| Autoatendimento (teste A/B real, n=27,8 mil) | base | +4,9 pp |
| tNPS (teste A/B real, n=2,0 mil) | base | +36,7 pts |
| Correlação nota simulação x produção | não informado | r = 0,74 |
Fonte: a palestra e Nubank, sala de imprensa (5/11/2026)
3. Por que persona sintética por prompt puro é "a média da média da internet"
Caio atribuiu a frase-chave a um amigo que trabalha com LLM desde o Transformers: persona sintética feita no chute gera "estereótipos, caricatos, copos genéricas que não convertem ninguém", porque não tem dor no bolso, não tem pressa, não passa por cartão recusado. O slide "O que a literatura já mediu" cita três papers que sustentam exatamente isso.

Segundo o paper de Santurkar et al. (ICML 2023, "Whose Opinions Do Language Models Reflect?"), modelos respondendo pesquisa de opinião puxam para um perfil mais escolarizado, liberal e rico mesmo quando instruídos a adotar outra persona, e esse viés persiste após a tentativa explícita de direcionamento. O estudo usa o framework OpinionQA sobre o American National Election Study e mostra desalinhamento comparável à divisão partidária americana sobre mudança climática.
O segundo paper citado, de Bisbee et al. (Political Analysis, 2024), é ainda mais direto sobre o problema da variância: a resposta sintética ingênua tem variância artificialmente baixa e muda com pequenas alterações de prompt, inclusive ao longo de um período de três meses com o mesmo prompt. É a ideia que Caio resumiu na sala: "Setecentas personas num prompt são uma persona", porque o modelo probabilístico tende ao token mais provável, reduzindo a diversidade de respostas a um recorte homogêneo.
4. A arquitetura: dados públicos, fatos com fonte e zero chamada de LLM no servidor
A solução de Caio foi inverter a lógica: em vez de pedir à LLM que invente um perfil, o painel usa atributos reais (IBGE, Bacen, Caged e pesquisas públicas de bancos e consultorias) organizados em pequenos arquivos markdown, cada um ligado deterministicamente a um atributo de persona.

"A gente usa atributos reais. Dezenas de fontes públicas, IBGE, Bacen, e dezenas de fontes públicas para tentar ligar a persona a atributos reais documentados."
O mecanismo de cruzamento foi exemplificado com o fato "dívida no cartão": um markdown pequeno registra que 85,1% da população brasileira tem dívida ativa no cartão (fonte: CNC), com um filtro que só se aplica a personas cujo campo divida_ativa é "Sim". Assim, o fato só é injetado no contexto de quem se qualifica, criando variância artificial estruturada em vez de depender da criatividade do modelo.
Cada persona final carrega um JSON com cerca de 18 atributos (classe social, idade, região, profissão, banco principal, dívida ativa, valor da dívida) sorteados respeitando a distribuição real da população segundo Bacen e Caged, e o contexto narrativo é montado a partir do cruzamento desses atributos com os fatos documentados. O resultado, segundo o slide de arquitetura, são 787 pessoas e 105 fatos com fonte, com zero chamadas de LLM dentro do servidor que guarda o vault de dados.
5. O backtest: onde o painel acerta e onde o erro dispara
Caio testou o painel contra uma pesquisa real da AgileWall (2025) sobre comportamento bancário digital. O erro foi baixo em perguntas estruturais e cresceu em perguntas dependentes de experiência vivida.

Tabela 2. Backtest do painel contra pesquisa real (AgileWall, 2025)
| Pergunta | Pesquisa real (%) | Painel (%) | Erro (pp) |
|---|---|---|---|
| Pretende manter ou aumentar uso de bancos digitais | 84,9 | 86 | 1,1 |
| Rapidez do cadastro é o fator nº 1 na abertura de conta | 51,4 | 49 | 2,4 |
| A casa é o lugar mais seguro para acessar o banco | 68,5 | 74 | 5,5 |
| Medo de a instituição quebrar e perder o dinheiro | 35 | 39 | 4,0 |
Fonte: a palestra
"Toda vez que uma pergunta depende de uma história passada [...] experiência vivida, não retrata que a pessoa já sofreu algum roubo, se o cartão dela já foi clonado, etc. [...] a gente começa a divergir mais aqui quando essas perguntas necessitam de histórias passadas ou de experiências passadas."
O comparativo mais contundente da palestra foi contra o uso de LLM pura sem arquitetura: na primeira pergunta (uso de bancos digitais), Gemini e GPT chegaram perto da pesquisa real (84% e 85% contra 84,9% real), mas nas perguntas seguintes o erro de ambos disparou (18% e 25% contra 51,4% real na pergunta sobre cadastro; 90% de GPT contra 68,5% real sobre segurança em casa). Caio chamou isso de aleatoriedade: não há padrão estável de erro ao perguntar direto a um modelo genérico.
Tabela 3. Segurança financeira por classe social: painel versus benchmark sem quebra
| Classe | Sente-se inseguro no painel (%) | Amostra |
|---|---|---|
| A | 5 | n=22 |
| B | 20 | n=30 |
| C | 77 | n=30 |
| D/E | 80 | n=30 |
Fonte: a palestra, citando BCG e Nubank, "Beyond Access" (out/2023)
O benchmark original da BCG com Mastercard e Nubank ("Beyond Access: A Look into the Drivers of Long-Term Financial Health", abril de 2024) mapeia a jornada de inclusão financeira no Brasil, mas, segundo Caio, não publica a quebra por classe social que o agregado de 70% de insegurança sugere. O painel reproduziu um gradiente coerente (de 5% na classe A a 80% nas classes D/E), enquanto Gemini e GPT, segundo o slide, ficaram fora da faixa do agregado (55% e 60% versus mais de 70% do benchmark).
6. Onde usar e onde não usar, segundo a própria experiência de Caio
A palestra fechou com uma lista explícita de usos recomendados e não recomendados, reforçada pelo slide de exemplos por domínio (SaaS B2B, e-commerce).

"O que é arriscado? [...] frequência e hábito declarado [...] valores em geral, então elasticidade de preço [...] satisfação, então perguntar NPS para a persona sintética eu não recomendo [...] experiências passadas em geral [...] e a maioria das perguntas ligadas ao emocional."
Funcionam bem, segundo ele: priorização de features, identificação de atrito em etapas de onboarding, e teste A/B (inclusive testes A-a-Z, comparando dezenas de variantes de uma vez, algo inviável com pesquisa humana tradicional por restrição de tempo e amostra). Funcionam mal: hábito declarado, elasticidade de preço, NPS/satisfação, experiências passadas e perguntas emocionais, exatamente as áreas em que falta dado público correlato.
7. Do dado público ao dado interno: a ordem importa
Em resposta a pergunta da plateia, Caio foi explícito sobre a sequência de construção: primeiro dados públicos, depois dados internos da empresa.
"Isso foi por dados públicos, só depois seria usado a empresa [...] quando você tenta criar, principalmente olhando para fora do mercado [...] o dado público te ajuda a trazer essa visão geral do mercado, dado interno te ajuda a trazer uma visão muito mais parecida com o seu cliente."
A justificativa: dado interno carrega o viés do segmento onde a empresa já tem mais market share. Usar só dados internos reforça o ponto cego da própria base de clientes. Caio recomendou, para quem for expandir o painel com dados próprios, priorizar comentários de NPS/CSAT, tickets de ouvidoria e reviews de app como fontes de "voz" da persona, para evitar a verborragia genérica da LLM.
Onde as fontes discordam
A literatura lida sustenta integralmente o diagnóstico de viés que motivou a arquitetura de Caio. Santurkar et al. (2023) e Bisbee et al. (2024) confirmam, com metodologia e dados distintos dos dele, que LLM pura falha tanto em representatividade (puxa para perfil mais escolarizado e liberal) quanto em variância (resposta sintética ingênua é artificialmente homogênea e sensível a mudanças mínimas de prompt). Nisso não há contradição, apenas reforço.
O ponto de atrito está no enquadramento do case Nubank. Na palestra, o resultado é apresentado como prova de que persona sintética acelera decisão de produto. A nota oficial do Nubank (5/11/2026) é mais cautelosa: destaca explicitamente que a taxa de autoatendimento, isoladamente, "não comprova que todos os problemas foram resolvidos com sucesso" e que o papel do simulador é classificar corretamente alternativas, não reproduzir perfeitamente o comportamento humano, condicionando ainda os ganhos de tNPS e autoatendimento à comparação entre dois agentes com escopos de tarefa diferentes (Card Management atende um conjunto mais amplo de tarefas que o Card Delivery usado como controle). A palestra não menciona essa ressalva metodológica do próprio Nubank.
Sobre o teto de desempenho possível para personas sintéticas, o slide da palestra cita Park et al. (2024) chegando a 85% de consistência do próprio indivíduo simulado, mas essa referência não constava entre as fontes lidas para verificação nesta edição; fica como lacuna a confirmar.
O que fazer agora
- Se a decisão for sobre priorização de features, atrito em onboarding ou ranqueamento de variantes em teste A/B, use persona sintética com base em dados públicos como primeiro filtro antes da pesquisa cara, documentando o erro médio esperado (na ordem de 1 a 3 pp em perguntas estruturais, mas podendo passar de 5 pp em perguntas que dependem de experiência vivida).
- Se a pergunta envolver satisfação (NPS/CSAT), elasticidade de preço, hábito declarado ou experiência emocional/passada, não use o painel sintético como fonte única; valide direto com pesquisa humana, porque a própria arquitetura carece de dado público correlato para essas dimensões.
- Se a equipe for montar um painel próprio, comece pelos dados públicos (IBGE, Bacen, Caged, dadosabertos.gov.br e releases de consultorias como BCG, McKinsey, Bain) antes de incorporar dados internos de CRM, para não herdar o viés do segmento onde a empresa já tem mais market share.
- Se o objetivo for velocidade de ciclo de teste de um agente de atendimento ou chat, siga o modelo do caso Nubank: rode a simulação para escolher a melhor versão antes do A/B real com clientes, mas trate a taxa de autoatendimento como indicador parcial, sempre acompanhado de métrica de qualidade e satisfação.
- Se a meta for reproduzir o painel apresentado, ele está publicado com código aberto no GitHub e operando como servidor MCP conectável via URL a qualquer agente compatível (Claude, Cursor, Antigravity), sem necessidade de instalação local.