Em resumo
A apresentação argumentou que o próximo salto depois dos assistentes de código não é um modelo mais esperto, mas um agente pessoal sempre ativo que acumula contexto sobre você e age proativamente, e que isso só funciona se vier acompanhado de mecanismos de confiança e segurança. No palco, o argumento seguiu uma lógica de três blocos: como construir (agentes pessoais always-on), como confiar no que é gerado (revisão, CI/CD, provas visuais) e como manter isso seguro (Daybreak). Fechou com um apelo para desenvolver "taste" como a habilidade humana que resta central quando a execução vira commodity.
- Agentes pessoais always-on (chamados de "dots" pela OpenAI) guardam contexto que vive "na cabeça" do usuário e não em documentos.
- A proatividade só funciona com acesso a contexto, ferramentas e guardrails bem calibrados.
- Mais agentes gerando PRs significa mais necessidade de CI/CD, testes e prova visual (screenshots, vídeos) para manter revisão humana viável.
- Segurança de aplicações exige defesa contínua, não uma varredura pontual, com o programa Daybreak como ponto de entrada.
- "Taste", a capacidade de descrever o que funciona e por quê, foi apresentada como a habilidade que distingue quem constrói bem na era dos agentes.
- 440%Alta no tempo mediano de revisão de código com mais adoção de IA, segundo o Faros AI Engineering Report citado por Michaela Greiler
- 31%Aumento de PRs mergeados sem revisão, segundo a mesma fonte
- 4.000Número de aplicativos a que os dots da OpenAI podem se conectar via plugins, segundo a documentação oficial
- 400 bilhõesAchados de segurança processados por ano pela plataforma da ArmorCode, integrada ao Daybreak Defense Factory
1. O argumento de abertura: de autocomplete a agentes proativos
A apresentação começou situando a virada histórica em dois anos: de um autocomplete "mágico" tipo Cursor Tab até agentes de codificação completos, e disso para assistentes que vivem dentro de aplicativos inteiros. O ponto central é que, a cada nova capacidade, o gargalo deixa de ser o modelo e passa a ser o desenho do produto em torno dele.
I remember starting at OpenAI around two years ago, and around that time having good autocomplete like cursor tap felt magical to me.
O primeiro conselho prático, antes de entrar em agentes, foi explicitamente contra o hype cíclico: não adotar toda novidade, e sim mapear os próprios gargalos.
The first thing that I want you to take away is that you don't have to adopt every new thing. (...) instead, you should focus on what are the things that are limiting you right now.
A comparação feita foi com o ciclo de frameworks JavaScript de uma década atrás, em que cada semana trazia uma ferramenta anunciada como definitiva. A recomendação prática foi avaliar se um novo modelo ou agente muda de fato o que é possível fazer, e só então adaptar o fluxo de trabalho.
2. Como construir: agentes pessoais sempre ativos ("dots")
A tese central da palestra é que o contexto disperso (em documentos, threads, memória do próprio usuário) é o problema que os agentes pessoais always-on resolvem. A apresentação chamou esse produto de "dots", construído sobre o mesmo harness de código aberto do Codex.
We've all known the situation where you have context flying all over the place (...) there's still some context that lives in my head that brings all of these things together.

Segundo a documentação oficial da OpenAI ("Introducing dots"), um dot roda em seu próprio computador na nuvem, aprende com feedback ao longo do tempo e se conecta a mais de 4.000 aplicativos via plugins, operando em ChatGPT, Slack e Teams com o mesmo contexto compartilhado entre canais. Isso confirma e detalha o que a apresentação descreveu de forma mais narrativa: múltiplas threads rodando em paralelo (laptop, dev box, Codex Cloud), cada uma com objetivos e contexto próprios, que o dot cruza e prioriza.
Os exemplos dados no palco mostram o padrão de uso: um colega pede via Slack para garantir que um PR seja mergeado em certo horário; o dot não só faz o merge como acompanha o deploy e testa se o problema relatado foi resolvido. Em outro caso, o dot percebeu que um colega já havia corrigido o mesmo bug e cancelou o próprio PR antes da revisão humana. Em um terceiro, o dot sinalizou proativamente um bug no Codex Harness relacionado a uma tarefa recorrente de limpar espaço em disco.
Not only did it go and merge it on time, it actually made sure that it got deployed and then followed through testing the deployed PR to make sure that the problem (...) was actually resolved.

A condição apontada para essa proatividade funcionar é tripla: acesso ao contexto necessário, acesso às ferramentas certas e guardrails adaptados ao longo do tempo, numa espécie de gestão de desempenho do próprio agente.
All of this proactivity only really works, though, if you make sure that your agent has access to the necessary context that it needs, the access to the tools that it can actually perform the necessary tasks.
3. Como confiar no que é produzido: revisão continua sendo humana
O crescimento do volume de contribuições gerado por agentes foi apresentado como o novo gargalo, citando o crescimento "drástico" de contribuições ao monorepo interno da OpenAI. A fonte lida de Michaela Greiler detalha esse fenômeno com dados de terceiros: o Faros AI Engineering Report, analisando telemetria de 22 mil desenvolvedores, registra aumento de cerca de 440% no tempo mediano de revisão e alta de 31% em PRs mergeados sem revisão, à medida que a adoção de IA cresce.
Tabela 1. Efeitos da adoção de IA na revisão de código, segundo fontes diferentes
| Métrica | O que a palestra mostrou | O que a fonte Greiler/Faros mostra |
|---|---|---|
| Volume de PRs | Crescimento "drástico" no monorepo interno | Mais PRs por desenvolvedor |
| Tempo de revisão | não informado | Alta de cerca de 440% no tempo mediano |
| PRs sem revisão | não informado | Alta de cerca de 31% |
| Tamanho dos PRs | não informado | Maiores, mais difíceis de avaliar |
Fonte: a palestra e Michaela Greiler (post de 2026, "When Agentic Coding Breaks Code Review")

A resposta proposta no palco não é abandonar a revisão, mas torná-la viável: manter ownership humano, não atribuir ou culpar a IA por algo que foi criado, e investir em lint, testes e documentação de requisitos que antes não existiam formalmente, como user journeys validadas por computer use.
Because ultimately, even at that scale, it's important for us to retain ownership and not to just claim or blame AI for having created something.
Duas táticas concretas foram recomendadas para reduzir o custo de revisão sem abrir mão dela:
- Ter CI/CD, mesmo que mínimo: "se você não tem CI/CD, peça ao seu agente para configurar algo";
- Anexar prova visual aos PRs gerados por agente, como screenshots ou vídeos de navegação pela aplicação (computer use), para que o revisor confirme o comportamento sem reconstruir o raciocínio inteiro.
If you don't have CI CD at this point, just ask your agent to set up something. At bare minimum, that's better than not having anything.
Segundo o guia da CodeRabbit sobre revisão agêntica, essa não é uma substituição da revisão humana, e sim uma camada de investigação adicional: o agente de revisão reúne contexto do repositório, segue dependências e explica achados, mas a decisão de merge e a responsabilidade permanecem com humanos através de status checks e aprovações obrigatórias configuráveis em branch protection. Isso reforça o ponto da palestra de que ownership não se delega, mesmo quando a execução é automatizada.
Um último ponto sobre confiança foi o tratamento de erros recorrentes: ao identificar por que um agente cometeu um erro, a correção deve ser codificada de volta no repositório via testes ou linters, para que o mesmo erro não se repita.
Why did it happen in the first place? How did the agent make this mistake? (...) encode that back into the repository through tests, linters or other requirements.
4. Segurança: de varredura pontual a defesa contínua
A apresentação tratou segurança como extensão direta do problema de confiança: já que modelos estão cada vez melhores em encontrar vulnerabilidades (inclusive modelos open-weight disponíveis a qualquer atacante), a defesa também precisa ser contínua e automatizada, não um exercício isolado.
Models are becoming increasingly better at finding vulnerabilities (...) it's important for us that we don't see ourselves as a one-off to find a vulnerability, but that we are building continuous defense mechanisms.

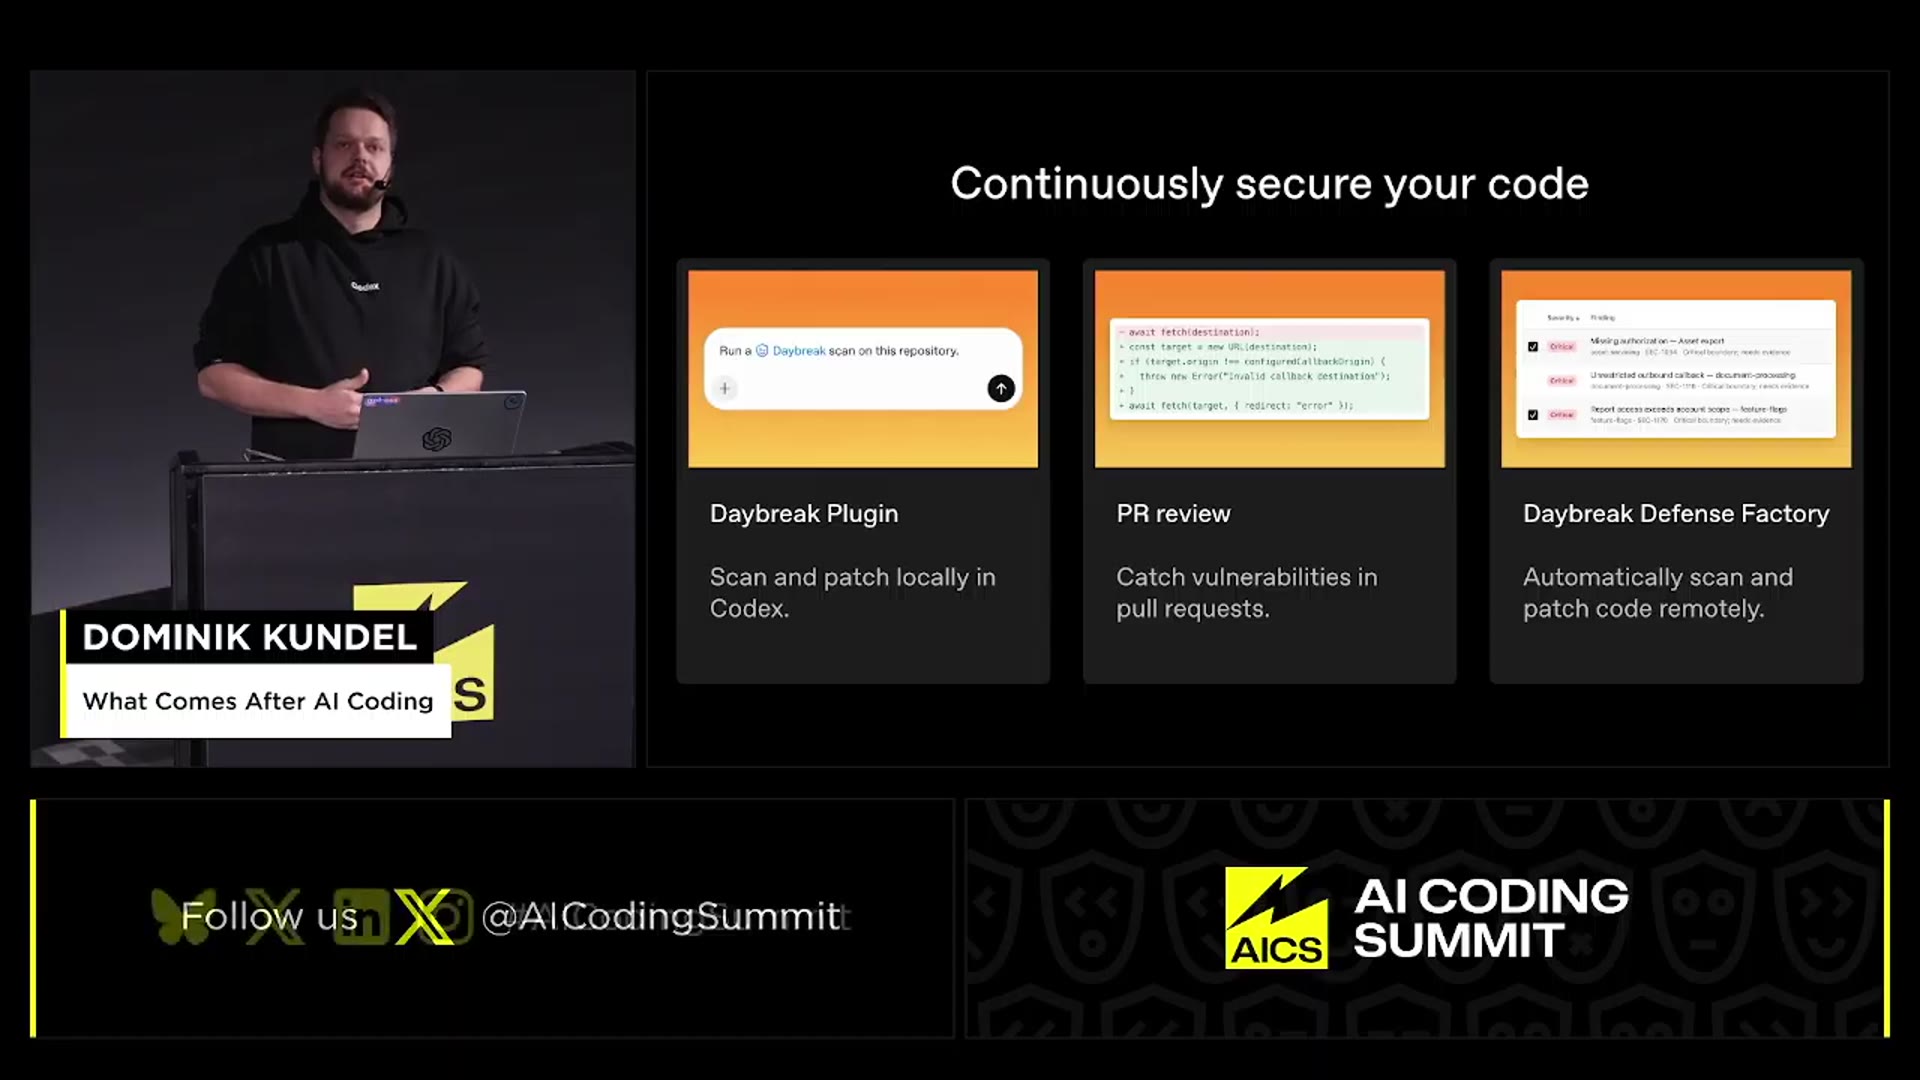
A recomendação prática seguiu uma progressão de maturidade em três camadas, visível no próprio slide: começar pelo Daybreak Plugin (varredura e correção local no Codex), evoluir para PR review automatizado (capturar vulnerabilidades em pull requests) e, na ponta, adotar o Daybreak Defense Factory, que varre repositórios remotamente e sugere patches de forma automática, executável em Codex Cloud. Para quem quer ir além, a apresentação mencionou o Daybreak Red para red teaming autorizado e testes de penetração.
Tabela 2. Camadas do programa Daybreak citadas na palestra
| Camada | Onde roda | Função |
|---|---|---|
| Daybreak Plugin | Local, no Codex | Varre e corrige vulnerabilidades no ambiente do desenvolvedor |
| PR review | No fluxo de pull request | Captura vulnerabilidades novas antes do merge |
| Daybreak Defense Factory | Remoto, via Codex Cloud | Varre repositórios automaticamente e sugere patches |
| Daybreak Red | não informado | Red teaming e testes de penetração autorizados |
Fonte: a palestra
A documentação técnica da OpenAI ("Codex as a platform") situa o Daybreak dentro de uma seção mais ampla de "Safety and governance", ao lado de red teaming, safety checks e cybersecurity checks, o que indica que a empresa trata isso como parte da arquitetura do harness, não como um produto avulso.
Já o blog da ArmorCode, publicado na mesma semana da apresentação, detalha uma integração concreta: achados de segurança priorizados fluem da plataforma da ArmorCode (que processa mais de 400 bilhões de achados por ano, agregando 425 integrações) para o Daybreak Defense Factory, que valida se a vulnerabilidade é real e propõe um patch de causa raiz para revisão humana, com achados do código retroalimentando a ArmorCode.
Daybreak Defense Factory builds on Codex Security to help AppSec teams investigate vulnerabilities and prepare proposed fixes. It analyzes a codebase, builds a threat model, validates that a vulnerability is real, and proposes a root-cause patch for review.
Essa integração reforça o argumento da apresentação de que a defesa precisa ser "contínua" e distribuída entre ferramentas, e não dependente de um único scanner.
5. O que sobra para o humano: construir "taste"
O fechamento da apresentação mudou de registro técnico para uma reflexão sobre critério. A tese é que, como executar praticamente qualquer ideia ficou acessível, a escassez se deslocou da capacidade de construir para a capacidade de discernir o que vale a pena construir.
Nobody can build what they want, they just need to be able to say what they want. But I think it's important for us, as developers, as engineers, as product leaders.
A definição de "taste" usada no palco foi emprestada de um colega: a habilidade de descrever o que você gosta e de prever o que outras pessoas vão gostar. A justificativa prática é que, com protótipos ficando baratos, times vão gerar múltiplas variações da mesma ideia, e alguém precisa decidir qual delas é melhor e por quê, com vocabulário específico, não apenas "sim" ou "não".
A really important part of that is that vocabulary, that ability to not (...) just say yes, no, but to say what are the things that are being done well and how they are being done well.
A apresentação listou práticas concretas para desenvolver esse critério, citando um colega ("se você quer fazer, você tem que comer"): jogar outros jogos para entender o que torna algo divertido, testar concorrentes para identificar por que funcionam melhor, e aprender vocabulário técnico de motion graphics para descrever o que de fato se gosta em um vídeo.
Uma fonte independente lida, do blog Muzli sobre design de produto, chega a uma conclusão complementar partindo de outro ângulo: taste não é colecionar referências bonitas, mas entender por que algo funciona, construído através de uma biblioteca curada de inspiração com justificativa explícita para cada escolha. Isso confirma o argumento da palestra de que "taste" é uma habilidade praticável, não um dom inato, embora a fonte Muzli enfatize mais o processo de curadoria pessoal do que a dimensão de liderança de equipe mencionada no palco.
If you're a leader, it's your responsibility to make sure your team can figure out what they like and develop your team.

O exemplo final, sobre pessoas migrando para jogos, mundos 3D e até design de hardware (PCBs, modelos físicos) por não terem mais a barreira de não saber modelar em 3D, ilustra o argumento de fechamento: a ambição do que se constrói deveria crescer junto com a capacidade de execução, mas orientada por critério, não apenas por curiosidade técnica.
Onde as fontes discordam
As fontes lidas, em geral, sustentam a descrição técnica da palestra, mas divergem no tom sobre o quanto a revisão humana está de fato se sustentando. A documentação e os materiais da própria OpenAI (Introducing dots, Codex as a platform) descrevem safeguards como "auto-review", permissões granulares e supervisão de segurança embutidas por padrão, sugerindo que o sistema já absorve boa parte do risco antes de chegar ao humano.
Michaela Greiler, por outro lado, documenta com dados (aumento de 440% no tempo de revisão, 31% de PRs sem revisão) que, na prática, muitas equipes estão em "rendição de revisão": aprovam superficialmente ou pulam a revisão porque não conseguem acompanhar o volume, mesmo com ferramentas de apoio. Isso contradiz, ou ao menos relativiza, a confiança implícita da palestra em CI/CD e provas visuais como solução suficiente: a fonte argumenta que o problema é estrutural (a assimetria entre gerar e verificar código desapareceu), não apenas uma questão de configurar mais checks.
A palestra não detalhou números de adoção, taxa de erro dos dots ou custo operacional de manter agentes always-on, nem comparou o Daybreak com concorrentes de segurança de código. Sobre esses pontos, as fontes lidas também não preenchem a lacuna de forma completa, e permanece em aberto quanto tempo humano, de fato, a revisão com apoio de IA está economizando na prática, fora dos exemplos internos citados pela própria OpenAI.
O que fazer agora
- Se o seu time já gera mais PRs do que consegue revisar com atenção, priorize CI/CD mínimo e provas visuais automatizadas antes de adicionar mais agentes ao fluxo, seguindo a recomendação da palestra e evitando o padrão de "rendição de revisão" descrito por Greiler.
- Se você está avaliando um agente pessoal always-on, comece mapeando onde o contexto se perde hoje (documentos, threads, memória de uma pessoa só) antes de escolher a ferramenta, porque esse foi o problema que motivou os dots, não o inverso.
- Se a sua aplicação ainda não tem varredura de segurança contínua, comece pela camada local (equivalente ao Daybreak Plugin) e só avance para varredura remota automatizada depois de validar que os PRs gerados por agentes mantêm ownership e revisão humana efetiva.
- Se sua equipe de produto ou design está acelerando a geração de protótipos com IA, invista deliberadamente em vocabulário crítico (o que funciona, por que funciona) antes de aumentar o volume de variações, porque a decisão entre opções passou a ser o gargalo, não a geração delas.