AWS Lambda passa a suportar GPU para rodar inferência de IA sem gerenciar infraestrutura
- Leitura
- 6 min
- Código
- 3
- Fontes
- 1
A AWS anunciou suporte a instâncias GPU para funções do Lambda Managed Instances, permitindo rodar inferência de modelos, processamento de mídia e renderização sem provisionar driver, CUDA ou cluster.
A AWS↳AWS20 conteúdosE-mails de verificação com AWS SES + Lambda (Node.js) e Terraform: do zero ao envioDevSecOps · out 2025Codex na AWS: chegada do agente da OpenAI à nuvem da AmazonDevSecOps · abr 2026Salesforce e AWS ampliam colaboração em IA, CRM e marketplaceDevSecOps · nov 2023Ver tudo em DevSecOps → anunciou, via AWS News Blog, que o Lambda Managed Instances (LMI) agora suporta instâncias EC2 da série G para rodar GPU dentro de Event Functions. Na prática, isso significa inferência de machine learning↳Machine learning39 conteúdosClassificador de Sentimentos – Azure MLData · abr 2019Inteligência Artificial e Machine Learning: O que você precisa saberAI · fev 2024Inteligência Artificial: seminário online da USP debate o futuro do aprendizado de máquinaGestão Dev & TI · jun 2021Ver tudo em AI →, processamento de mídia, renderização e computação científica usando GPU com o mesmo modelo de programação do Lambda: sem provisionar driver, sem reconciliar versão de CUDA, sem cluster Kubernetes com device plugin para GPU.
Para quem já tentou rodar GPU em produção sabe que a parte chata nunca é o modelo, é a infraestrutura em volta dele. Escolher a instância certa, manter driver NVIDIA e CUDA sincronizados com a imagem, dimensionar capacidade, escrever lógica de auto-scaling e plugar isso em filas e eventos da AWS é trabalho repetitivo que não agrega ao produto. O Lambda está tentando tirar essa camada do seu prato.
O que muda por baixo do capô
Uma função GPU-accelerated no Lambda é publicada como imagem de container (OCI), igual a qualquer função Lambda baseada em container, só que apontando para um CapacityProviderConfig com GPU. Você cria um capacity provider informando os tipos de instância aceitos (g5.2xlarge, g6.2xlarge, g6e.2xlarge, por exemplo) e o Lambda escolhe a opção mais barata disponível, caindo para outra geração se a capacidade estiver apertada:
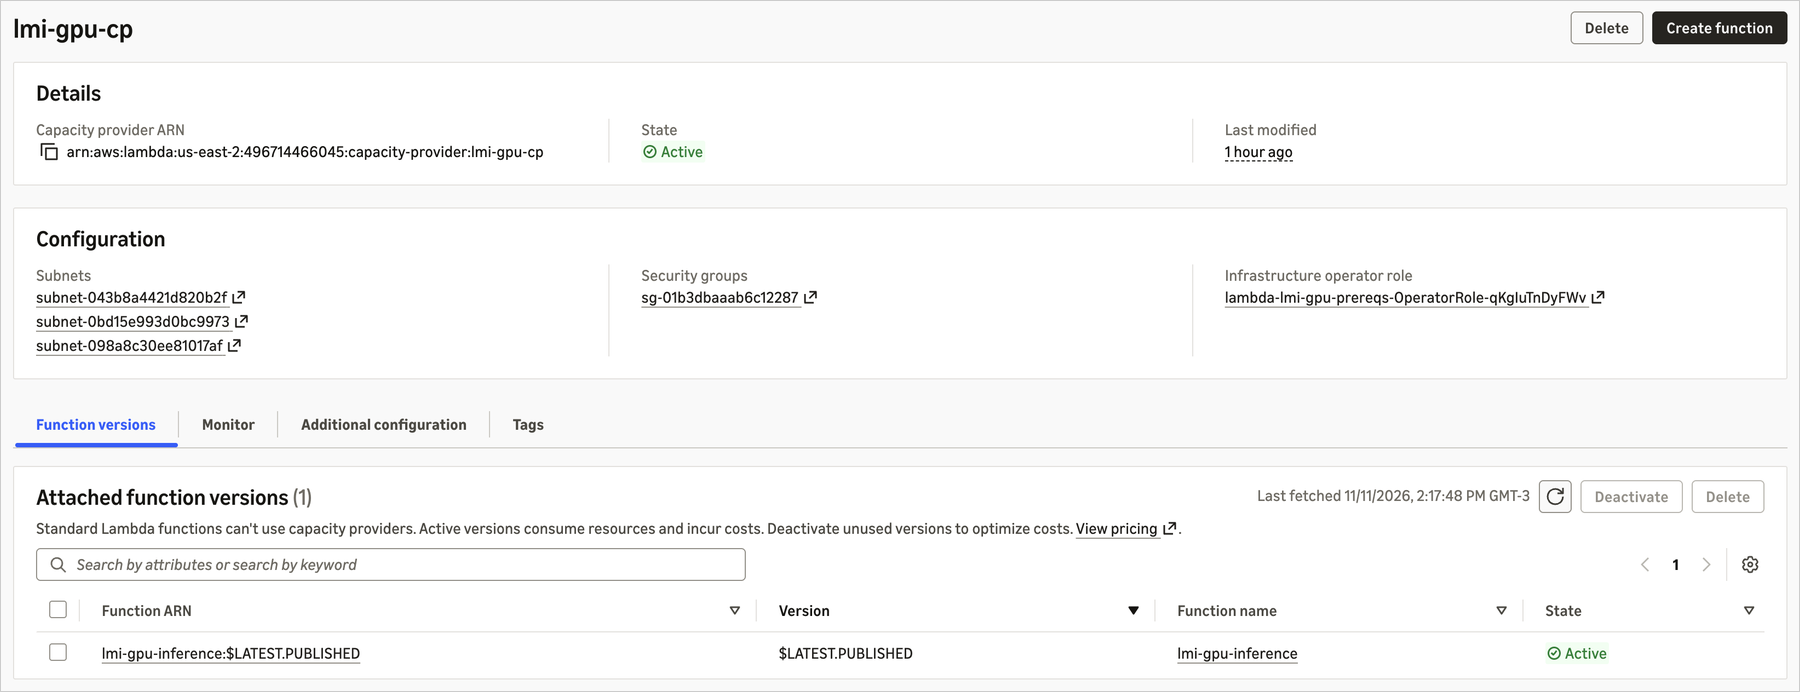
{
 "CapacityProviderName": "lmi-gpu-cp",
 "InstanceRequirements": {
 "AllowedInstanceTypes": ["g5.2xlarge", "g6.2xlarge", "g6e.2xlarge"]
 },
 "CapacityProviderScalingConfig": {
 "ScalingMode": "Auto",
 "MaxVCpuCount": 96
 }
}
A AWS disponibiliza imagens base curadas (base:cuda, pytorch:cuda, vllm:cuda, sglang:cuda) que já trazem CUDA toolkit, PyTorch, Transformers e FFmpeg resolvidos. No exemplo do próprio post, o Dockerfile inteiro para servir um LLM via vLLM é uma linha:
FROM public.ecr.aws/lambda/deep-learning-containers/vllm:cuda-v1Você aponta a variável de ambiente MODEL_ID para um repositório no Hugging Face, no ModelScope, ou para um bucket no Amazon S3, e o runtime baixa os pesos, gerencia a memória da GPU e sobe um endpoint compatível com a API da OpenAI. Nenhuma linha de código de inferência é escrita.
O exemplo concreto: de zero a endpoint em 10 minutos
No teste publicado pela AWS, o fluxo foi: criar o capacity provider, construir e subir a imagem para o Amazon ECR, criar a função apontando AcceleratorConfig.AcceleratorMemorySize para 16 GB, publicar uma versão e invocar. A publicação da versão é o momento em que o cold start acontece: os execution environments sobem, baixam os pesos do modelo (Qwen/Qwen2.5-1.5B-Instruct no caso) e aquecem o motor de inferência antes de ficarem ativos, então quem invoca depois não paga esse custo.
aws lambda invoke \
 --function-name 'lmi-gpu-inference:$LATEST.PUBLISHED' \
 --cli-binary-format raw-in-base64-out \
 --payload '{"messages": [{"role": "user", "content": "Explain serverless GPU inference in one sentence."}], "max_tokens": 128}' \
 /dev/stdout
Quatro invocações concorrentes terminaram no mesmo tempo que uma única, porque o parâmetro PerExecutionEnvironmentMaxConcurrency faz o vLLM empacotar requisições no mesmo processo em GPU, compartilhando uma cópia do modelo em memória. É esse batching que decide se a GPU que você paga fica ociosa ou ocupada: subir esse valor aumenta throughput sem subir instância nova.
O preço da conveniência
Aqui mora o trade-off que todo mundo que trabalha com confiabilidade e custo precisa olhar de frente antes de migrar algo pra esse modelo. Você paga a tarifa da instância EC2 subjacente (elegível a Savings Plans e Reserved Instances), mais uma taxa de gestão de 9,75% sobre instâncias GPU, mais a tarifa padrão de requisição do Lambda de US$ 0,20 por milhão. Em troca, você não opera fleet de GPU, não escreve scaling policy e não mantém driver.
Em resumo: o modelo de cobrança penaliza GPU ociosa do mesmo jeito que GPU self-managed penaliza, só que trocando o trabalho operacional por uma taxa percentual fixa. Para workloads com baixa utilização (um lote esporádico de inferência), isso ainda pode ser mais barato que manter um nó GPU ligado 24/7 em um cluster EKS. Para workloads constantes e de alta utilização, vale fazer a conta: a taxa de 9,75% sobre um g6e.2xlarge rodando o tempo todo pode superar o custo de operar um fleet pequeno e bem dimensionado internamente.
Outro ponto prático de dia a dia: contas novas começam com cota zero para instâncias G sob demanda, listada como "Running On-Demand G and VT instances". É preciso pedir aumento de cota antes de testar, o que pode levar horas ou dias dependendo da análise da AWS, e é um passo fácil de esquecer no planejamento de uma POC.
Onde isso se encaixa no modelo de programação
Uma função GPU-accelerated não vive isolada: ela é um passo dentro de um fluxo maior do Lambda. As Lambda durable functions orquestram workflows multi-etapa com checkpoint e recuperação automática ao redor do passo de GPU, e as Lambda MicroVMs rodam código não confiável ou gerado por modelo em sandbox isolado, chamando a função GPU só para a etapa de inferência. Isso é relevante para quem já desenha agentes: a lógica de tool-use roda em CPU barato, e só a inferência pesada sobe para GPU.
O recurso também herda o timeout estendido do Lambda Managed Instances, até 90 minutos para invocações assíncronas e event source mapping, o que cobre transcodificação de mídia e inferência multi-etapa sem reescrever a arquitetura em torno de um limite de 15 minutos. Os limites de container (até 32 GB, 10 GB por arquivo), armazenamento efêmero (até 32 GB), memória (2.048 a 32.768 MB) e até 48 requisições concorrentes por execution environment definem o teto prático de cada função.
Quando não vale a pena
A própria AWS é direta sobre o recorte: o recurso é otimizado para inferência, não para treinamento, e para modelos customizados de porte pequeno a médio, não para os grandes modelos de fundação já disponíveis no Amazon Bedrock. Se o caso de uso é consumir um foundation model genérico, Bedrock continua sendo o caminho mais direto; GPU no Lambda compensa quando o modelo é seu, fine-tuned, ou é uma tarefa específica (classificação, extração, visão computacional, texto para fala) embutida dentro de uma aplicação maior.
Também vale desconfiar em cenários de latência crítica de primeiro acesso: embora o cold start aconteça na publicação da versão e não na primeira chamada, trocar de modelo ou subir uma nova versão ainda exige esse aquecimento. E se a carga de trabalho satura a GPU o tempo todo, o ganho de "não gerenciar infraestrutura" compete diretamente com a taxa de gestão de 9,75% somada ao preço cheio da instância, o que pode inverter a conta a favor de um cluster próprio bem otimizado.
O recurso está disponível hoje, cobrindo as famílias G4dn, G5, G6, G6f, Gr6, Gr6f e G6e, com mais famílias de instância prometidas para o futuro. Para quem já usa Lambda como backbone de orquestração de eventos, a peça que faltava para incluir GPU no mesmo modelo, sem abrir uma segunda stack de infraestrutura só para isso, finalmente existe.
Fonte: AWS News Blog
Highlights
- AWS Lambda agora suporta GPU EC2 série G para inferência sem provisionar driver ou CUDA
- Instâncias G4dn, G5, G6, G6f, Gr6, Gr6f e G6e disponíveis; mais famílias prometidas
- Cold start acontece na publicação da versão, não em cada invocação; requisições concorrentes compartilham modelo
- Taxa de gestão de 9,75% sobre instância mais preço EC2; mais barato para carga esporádica
- Recurso otimizado para modelos customizados, não foundation models (use Bedrock para esses)
Este artigo foi escrito por Rafael Oliveira, colunista de DevOps. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Amazon EventBridge ganha bus único para múltiplas contas, mas ainda não chega ao Brasil
A AWS lançou uma versão reforçada do custom event bus do EventBridge, com ordenação garantida, um recurso único de assinatura e um novo modelo de preço. A região São Paulo fica de fora da lista inicial.